整理中
推荐拆分:8 大模块,约 35 篇
模块一:神经网络基础与训练机制(4~5 篇)
正则化全解析:L1、L2、权重衰减、Dropout
L1 稀疏解、L2 权重衰减
Dropout 的集成学习视角
AdamW 中的解耦权重衰减
数据增强与噪声注入:让模型在脏数据中变强
噪声增强、Mixup、CutMix
数据增强作为正则化
激活函数、归一化与残差连接
GELU/ReLU/SwiGLU
Norm 的位置:Pre-Norm vs Post-Norm
残差连接解决梯度消失
模块二:Transformer 与注意力机制(5~6 篇)
从 RNN 到 LSTM:上下文窗口固定的问题
RNN 记忆、梯度消失/爆炸
LSTM 门控机制
注意力机制详解:QKV、自注意力、多头注意力
QK 点积、加权求和
多头注意力为什么切分维度
Mask 掩码机制
Transformer 全景:FFN、位置编码、Add & Norm
FFN 升维降维
APE/RPE/RoPE/ALiBi
线性投影与向量化
注意力变种:MQA、GQA、MLA
分组注意力、多头量化
长上下文优化
长上下文的难点与优化
注意力残差、GQA
1M 上下文如何实现
KTransformers 与推理优化
算子优化、Flash Attention
数据传输优化与显存节省
模块三:优化器与训练调参(4~5 篇)
从 SGD 到 AdamW:大模型优化器演进
SGD 为什么被淘汰
Adam/AdamW 的动量与自适应学习率
Lion、Sophia 等新优化器
学习率、批次大小、预热与衰减
Warmup + Cosine Decay
批次大小对梯度稳定性的影响
Loss 曲线诊断:不下降、不收敛、过拟合
loss 不下降的 5 种原因
eval loss 上升 = 过拟合
测试集 loss 不下降 = 数据无关
防止过拟合的 4 种手段
- 早停、正则化、Dropout、数据增强
梯度裁剪、梯度累积与混合精度训练
梯度爆炸处理
显存优化
基础
正则化
L2参数正则化权重衰减、L1正则化
噪声进行数据增强
但是上下文窗口固定,RNN为其增加了记忆
但是RNN会引起梯度消失或梯度爆炸。引入LSTM,增加了门控机制

那多头注意力是什么意思呢?将原始的QKV切为h份(头数)
一开始多头注意力就是把维度进行切分,高维变成低维,如12个头,768维会切分为12个64维的
残差连接解决梯度消失

transformer -> 向量化、FFN(升维、降维)、线性投影
QKV(查询向量、键向量、值向量) Q和K进行点积运算,得到的每个结果作为系数,与V进行加权求和得到向量,就是attention机制
Add就是残差连接
Norm是归一化
位置编码 Learned/RoPE/ALiBi/Relative 绝对位置编码APE、相对位置编码RPE、旋转位置编码ROPE(现在基本用这种)
激活函数有哪些?为什么需要激活函数?大模型们选择了哪个 GELU/ReLU/SwiGLU
归一化?归一化的位置?
注意力机制、自注意力机制、多头自注意力(再加上掩码之后,mask后边的内容)。变种MQA、GQA、MLA
KTransformers
大模型的分词和ES的分词一样吗?有什么区别
位置编码的各种改进、归一化的各种改进、残差的各种改进、前馈的各种改进、注意力层的各种改进
组合模型 (Ensemble Methods):强强联合
- Bagging:并行训练多个模型并平均(如 Random Forest),降低方差。
- Boosting:串行训练,后续模型关注前序模型的错误(如 AdaBoost, Gradient Boosting),降低偏差。
- Mixture of Experts (MoE):
- 门控网络 (Gating Network):根据输入选择特定的专家模型。
- 现状:这是当前大模型(如 Mixtral, Qwen-MoE)的核心架构,PRML 中提到的“专家混合”是其理论雏形。
理解 Gate 如何学习路由,以及 Expert 如何专业化,有助于您调试 MoE 模型的负载平衡和收敛问题
如果您关注 LLM 的对齐(Alignment)或生成控制,VI 是理解 VAE 和扩散模型(Diffusion Models)的关键。DPO (Direct Preference Optimization) 的推导也深受极大似然和贝叶斯推断的影响。
决策树(信息增益、增益率<4.5、基尼指数)、防止过拟合、剪枝(预剪枝、后剪枝)
M-P神经元->GTP参数
SVM(核)处理非线性问题(高维变线性)
聚类(K均值算法)->RAG
核->注意力机制
BP算法->梯度
PCA(蒸馏和lora)
bagging(MOE 借鉴了该思想)
Bosting(RLHF思想)
模块四:微调与高效微调(5~6 篇)
Full Fine-tuning vs LoRA:微调到底改了什么?
全量微调、LoRA、QLoRA
低秩分解公式 ΔW = B·A
rank 选择 8~16
Prefix Tuning、Prompt Tuning、Adapter Tuning
增加额外参数的方法
推理速度与优化难度对比
BitFit、AdaLoRA、混合高效微调
选取部分参数更新
MAM Adapter、UniPELT
微调中的灾难性遗忘与解决方案
- 加入通用数据、低学习率、多任务学习
预训练 vs SFT:loss 计算的区别
预训练从头开始
SFT 只计算 output loss
蒸馏、白箱蒸馏与合成数据
知识蒸馏、Self-Instruct
合成数据生成
微调
Sft(有监督微调)
1.提示学习 2.语境学习(上下文)
涌现能力?
优化器、梯度下降算法有哪些
SGD随机梯度下降
SGD(随机梯度下降)本身不再直接用于大模型训练,但它的核心思想(随机采样 + 梯度更新)是所有现代优化器的基石。
简单来说:你每天都在用 SGD 的“后代”,但几乎不会直接用原始的 SGD。
1. 为什么原始 SGD 不适合大模型?
原始 SGD 的更新规则很简单:$\theta = \theta - \eta \nabla L(\theta)$
它在大模型训练中面临三个致命问题:
- 收敛极慢且震荡剧烈:大模型的损失曲面(Loss Landscape)非常复杂,充满鞍点和局部极小值。原始 SGD 没有动量(Momentum),容易在峡谷两侧来回震荡,难以深入底部。
- 学习率敏感:需要极其精细的学习率调度(Warmup + Decay),否则很容易发散或陷入停滞。
- 缺乏自适应能力:它对所有参数使用相同的学习率。但在大模型中,不同层、不同参数的梯度尺度差异巨大(例如 Embedding 层和 Attention 层的梯度分布完全不同)。
2. 现在大模型用什么?—— AdamW 是绝对主流
目前几乎所有大模型(包括 Qwen、Llama、GPT)的微调和预训练,默认使用的都是 AdamW。
| 特性 | SGD (原始) | Momentum SGD | Adam / AdamW |
|---|---|---|---|
| 动量 | ❌ | ✅ | ✅ (一阶矩估计) |
| 自适应学习率 | ❌ | ❌ | ✅ (二阶矩估计) |
| 权重衰减处理 | 耦合在正则化中 | 耦合在正则化中 | 解耦 (W 代表 Decoupled) |
| 大模型表现 | 差 | 一般 | 极好 |
为什么是 AdamW 而不是 Adam?
- 研究发现,标准的 Adam 中的权重衰减(Weight Decay)与 L2 正则化在自适应学习率下不等价。
- AdamW 修正了这一点,将权重衰减从梯度更新中解耦出来,对于大模型的泛化能力至关重要。
3. SGD 的“变体”还在用吗?
虽然原始 SGD 不用了,但它的某些改进版本在特定场景下仍有研究价值:
SGD with Momentum:
- 在某些视觉任务(如 ResNet 训练)中,精心调参的 SGD+Momentum 有时能达到比 Adam 更好的最终精度,但需要更长的训练时间和更复杂的学习率策略。
- 在大语言模型中极少使用,因为调参成本太高,且 AdamW 已经足够好。
Sophia / Lion 等新型优化器:
- 最近有一些研究试图挑战 AdamW 的地位,例如 Google 提出的 Lion 优化器,或者基于二阶信息近似的 Sophia。
- 它们在某些实验中声称能比 AdamW 节省计算量或提高收敛速度,但尚未成为工业界标准。Qwen、Llama 等主流模型依然坚持使用 AdamW。
4. 对你工作的实际影响
鉴于你正在使用 ms-swift 和 DeepSpeed 进行 Qwen 微调:
你不需要手动选择优化器:
ms-swift默认通常就是 AdamW。- 你可以在配置文件中看到类似
optimizer: adamw_torch或adamw_hf的设置。
你需要关注的是 AdamW 的超参数:
- Learning Rate (lr):最关键。LoRA 微调通常在 1e-4 到 5e-4 之间;全量微调可能更低。
- Weight Decay:通常设为 0.01 或 0.1,防止过拟合。
- Beta1, Beta2:Adam 的动量参数,通常保持默认 (0.9, 0.999)。
内存优化:
- AdamW 比 SGD 占用更多显存,因为它需要存储一阶矩(m)和二阶矩(v)两个状态变量。
- 这就是为什么你在使用 DeepSpeed Zero2/3 时,Optimizer State Partitioning 如此重要——它将 Adam 的状态变量切分到不同 GPU 上,从而节省显存。
总结
- 原始 SGD:❌ 大模型中已淘汰。
- AdamW:✅ 当前绝对主流,你正在用的就是这个。
- 学习建议:不需要去推导 SGD 的公式,但应该深入理解 AdamW 的工作原理(特别是动量和自适应学习率如何帮助大模型收敛),以及如何通过 DeepSpeed 优化其内存占用。
如果你遇到收敛问题,调整 Learning Rate Schedule(如 Cosine Annealing with Warmup)比换回 SGD 有效得多。
首先是工具调用能力评估(BFCL),专注于评估智能体的函数调用准确性,包含 simple、multiple、parallel、irrelevance 四个类别,使用 AST 匹配技术进行精确评估。其次是通用能力评估(GAIA),评估智能体的综合问题解决能力,包含三个难度级别共 466 个真实世界问题,关注多步推理、工具使用、文件处理等能力。第三是数据生成质量评估(AIME),评估 LLM 生成数据的质量,使用 LLM Judge 和 Win Rate 两种方法,支持人工验证和综合报告生成,确保生成数据达到参考数据的质量标准。
模型评估:准确率precision、精确率、召回率recall、F1分数 = 2*p*r/p+r
训练评测:
①留出法:留出一定比例的数据做评测集,与数据集互斥
②交叉验证:比如把数据分成十份,每次取九份训练,一份评测,需要训练10次,评测10次
③自助法:将数据集采样得出训练集
建议去调整下 top_p, num_beams, repetition_renalty, temperature, do_sample=True;
数据生成有重复,调高repetition_renalty;
生成任务表达单一的,样本也不多的,可适当调低 temperature,生成的样子跟训练集的比较像;如果要复现训练集的效果,temperature=0.01即可
在使用大模型时,你会经常看到类似Temperature这类的可配置参数,其本质是通过调整模型对 “概率分布” 的采样策略,让输出匹配具体场景需求,配置合适的参数可以提升Agent在特定场景的性能。
传统的概率分布是由 Softmax 公式计算得到的:pi=ezi∑j=1kezjp**i=∑j=1kezjezi,采样参数的本质就是在此基础上,根据不同策略“重新调整”或“截断”分布,从而改变大模型输出的下一个token。
Temperature:温度是控制模型输出 “随机性” 与 “确定性” 的关键参数。其原理是引入温度系数T>0T>0,将 Softmax 改写为pi(T)=ezi/T∑j=1kezj/Tp**i(T)=∑j=1kez**j/Tez**i/T。
当T变小时,分布“更加陡峭”,高概率项权重进一步放大,生成更“保守”且重复率更高的文本。当T变大时,分布“更加平坦”,低概率项权重提升,生成更“多样”但可能出现不连贯的内容。
- 低温度(0 ⩽⩽ Temperature << 0.3)时输出更 “精准、确定”。适用场景: 事实性任务:如问答、数据计算、代码生成; 严谨性场景:法律条文解读、技术文档撰写、学术概念解释等场景。
- 中温度(0.3 ⩽⩽ Temperature << 0.7):输出 “平衡、自然”。适用场景: 日常对话:如客服交互、聊天机器人; 常规创作:如邮件撰写、产品文案、简单故事创作。
- 高温度(0.7 ⩽⩽ Temperature << 2):输出 “创新、发散”。适用场景: 创意性任务:如诗歌创作、科幻故事构思、广告 slogan brainstorm、艺术灵感启发; 发散性思考。
Top-k:其原理是将所有 token 按概率从高到低排序,取排名前 k 个的 token 组成 “候选集”,随后对筛选出的 k 个 token 的概率进行 “归一化”: p^i=pi∑j∈候选集pjp^i=∑j∈候选集pjp**i
- 与温度采样的区别与联系:温度采样通过温度 T 调整所有 token 的概率分布(平滑或陡峭),不改变候选 token 的数量(仍考虑全部 N 个)。Top-k 采样通过 k 值限制候选 token 的数量(只保留前 k 个高概率 token),再从其中采样。当k=1时输出完全确定,退化为 “贪心采样”。
Top-p:其原理是将所有 token 按概率从高到低排序,从排序后的第一个 token 开始,逐步累加概率,直到累积和首次达到或超过阈值 p: ∑i∈Sp(i)≥p∑i∈S**p(i)≥p,此时累加过程中包含的所有 token 组成 “核集合”,最后对核集合进行归一化。
如果是0.6,则只考虑到60%的词,然后讲这些词概念同比扩大,减少长尾词输出
- 与Top-k的区别与联系:相对于固定截断大小的 Top-k,Top-p 能动态适应不同分布的“长尾”特性,对概率分布不均匀的极端情况的适应性更好。
在文本生成中,当同时设置 Top-p、Top-k 和温度系数时,这些参数会按照分层过滤的方式协同工作,其优先级顺序为:温度调整→Top-k→Top-p。温度调整整体分布的陡峭程度,Top-k 会先保留概率最高的 k 个候选,然后 Top-p 会从 Top-k 的结果中选取累积概率≥p 的最小集合作为最终的候选集。不过,通常 Top-k 和 Top-p 二选一即可,若同时设置,实际候选集为两者的交集。 需要注意的是,如果将温度设置为 0,则 Top-k 和 Top-p 将变得无关紧要,因为最有可能的 Token 将成为下一个预测的 Token;如果将 Top-k 设置为 1,温度和 Top-p 也将变得无关紧要,因为只有一个 Token 通过 Top-k 标准,它将是下一个预测的 Token。
生成分数->转换概念(softmax)->加权采样->温度->Top-p
训练的参数解释:批次大小、学习率、预热、衰减、优化器adam(adam_beta1: Adam系列优化器中一阶矩估计(动量)的指数衰减率。默认为0.9。 adam_beta2: Adam系列优化器中二阶矩估计(方差)的指数衰减率。默认为0.95。 adam_epsilon: Adam系列优化器中用于数值稳定性的epsilon值。默认为1e-8。 )、权重衰减、梯度裁剪。学习率的选择,轮次的选择
每个batch都会影响梯度调整,如果取1的话,且数据是噪声会影响调整错误
loss不下降①学习率太低②数据没有规律
loss下降不收敛①没有学完,增大轮次
loss上下起伏,不稳定下降①学习率过大②batchsize设置的太少
loss初期下降明显,后边不变了①学习到了瓶颈,可以调大学习率②达到局部最优了,可调大批次③过拟合了
加入eval loss后,如果loss还在下降,但是eval loss上升①过拟合
loss、eval loss都不下降①调大学习率,没学到东西
loss剧烈波动①batchsize太小,梯度不稳定②学习率太大,训练不稳定
loss曲线不趋于平滑:学习的还不够(增加数据或增加学习率)
测试集loss完全不下降:测试集与训练集数据无关
测试集loss下降:如果测试集loss下降显著大于训练集loss,表示过拟合
防止过拟合
①早停(差不多就行)②正则化(L1/L2正则化)抑制参数野蛮增长③Dropout(过于依赖部分参数,丢弃部分)④增加数据量或数据增强
微调
full和lora不改变模型?
- 增加额外参数,如:Prefix Tuning(难优化,改了输入层,在K之前加前缀,改变了模型)、Prompt Tuning、Adapter Tuning(加了一个Adapter插件,推理慢)及其变体。
• 选取一部分参数更新,如:BitFit。
• 引入重参数化,如:LoRA、AdaLoRA、QLoRA。(lora及其变体)lora的思想是low rank低秩(矩阵的rank(秩)),模型参数大,但是信息量没有那么多。使用了矩阵分解 公式:△w = B·A △w是d*d B是d*r A是r*d r远小于d 原参数量是d*d,A、B参数量是d*r*2。先选8-16,复杂的在进行上调
• 混合高效微调,如:MAM Adapter、UniPELT。
微调可能会导致遗忘,其他能力下降,调整的能力上升
解决方式:①加入通用数据②少改模型(学习率低)③多任务学习④只需要该能力,其他能力下降我不关心
类别不平衡问题?类别不平衡问题可以通过过采样、欠采样、生成新样本、集成学习等方法来解决。过采样方法包括随机过采样、
SMOTE等;欠采样方法包括随机欠采样、Tomek Links等;生成新样本方法包括GAN、VAE等;集成学习方法包括Bagging、Boosting等。
如何进行蒸馏?白箱蒸馏是什么?
合成数据?self-instruct


预训练和sft的区别:预训练是从头开始的,sft不用计算input的loss,只需要计算output的loss
模块五:强化学习与对齐(4~5 篇)
强化学习入门:从监督学习到奖励机制
有监督学习 vs 强化学习
幻觉改善与人类对齐
RLHF 三阶段:SFT → RM → PPO
奖励模型训练
PPO 的 4 模型问题
RLHF 的不足与替代方案
人工偏好数据成本高
RLAIF、RRHF、LIMA、DPO
规则奖励 vs 模型奖励
GRPO、GKD 的规则奖励
PPO 的奖励模型
DPO、RAFT、HIR:RLHF 的简化路径
二进制交叉熵目标
奖励排序微调
强化学习
有监督学习需要大量的标准回复。强化学习通过奖励机制进行打分,更容易改善幻觉问题
强化学习(人类对齐)
- 基于人类反馈的强化学习(RLHF) 需要先进行监督微调、训练奖励模型、进行强化学习
- 对于 GRPO 和 GKD 这类方法,官方推荐直接使用规则奖励 (Rule-based Reward),也称为结果奖励 (Outcome Reward)。这种方式你不需要额外加载一个模型来打分,而是通过函数直接根据模型的生成结果(如答案是否正确、格式是否规范)来计算奖励值
- 如果你需要使用PPO(近端策略优化) 这类方法,或者想用神经网络模型来提供更灵活的奖励信号,就需要先训练一个专门的奖励模型(Reward Model)
- RLAIF
. 如何解决 人工产生的偏好数据集成本较高,很难量产问题?
该方法的核心在于通过**AI 模型监督其他 AI 模型,即在SFT阶段,从初始模型中采样,然后生成自我批评和修**
正,然后根据修正后的反应微调原始模型。 在 RL 阶段,从微调模型中采样,使用一个模型来评估生成的样本,
• 大模型(LLMs)强化学习面
• 1 简单介绍强化学习?
• 2 简单介绍一下 RLHF?
• 3. 奖励模型需要和基础模型一致吗?
• 4. RLHF 在实践过程中存在哪些不足?
• 5. 如何解决 人工产生的偏好数据集成本较高,很难量产问题?
• 6. 如何解决三个阶段的训练(SFT->RM->PPO)过程较长,更新迭代较慢问题?
• 7. 如何解决 PPO 的训练过程同时存在4个模型(2训练,2推理),对计算资源的要求较高 问题?
• 致谢
\1. 不足点1:人工产生的偏好数据集成本较高,很难量产;
\2. 不足点2:三个阶段的训练(SFT->RM->PPO)过程较长,更新迭代较慢;
\3. 不足点3:PPO 的训练过程同时存在4个模型(2训练,2推理),对计算资源的要求较高。
• 解决方法:AI 专家替代派
• 代表方法:
\1. RLAIF
扫码加
查看更多并从这个 AI 偏好数据集训练一个偏好模型。 然后使用偏好模型作为奖励信号对 RL 进行训练,即 RL from AI
Feedback(RLAIF)。
\1. RRHF
RRHF(Rank Response from Human Feedback) 不需要强化学习,可以利用不同语言模型生成的回复,包括
ChatGPT、GPT-4 或当前的训练模型。RRHF通过对回复进行评分,并通过排名损失来使回复与人类偏好对齐。
RRHF 通过通过排名损失使评分与人类的偏好(或者代理的奖励模型)对齐。RRHF 训练好的模型可以同时作为
生成语言模型和奖励模型使用
6. 如何解决三个阶段的训练(**SFT->RM->PPO**)过程较长,更新迭代较慢问题?
• 解决方法:微调数据优化派
• 方法介绍:该类方法的核心在于仅仅通过优质数据集的获取和产生,以训练得到一个效果较好的
SFT 模型,而无需进行 RM 和 PPO 的训练。
• 代表方法:
\1. LIMA
LIMA(Less Is More for Alignment) 即浅层对齐假说,即一个模型的知识和能力几乎完全是在预训练中学习的,而
对齐则是教会它与用户交互时如何选择子分布。如果假说正确,对齐主要有关于学习方式,那么该假说的一个推
论是,人们可以用相当少的样本充分调整预训练的语言模型。因此,该工作假设,对齐可以是一个简单的过程,
模型学习与用户互动的风格或格式,以揭示在预训练中已经获得的知识和能力。
\1. MAYBE ONLY 0.5% DATA IS NEEDED
本文主要从数据角度来探讨如何降低 LLM 训练阶段的成本,提高数据效率。为了实现该目的,作者通过从现有
数据中识别出最有价值的核心样本来帮助模型获取下游任务的知识,并仅用少量数据来实现可比甚至更好的性
能。
7. 如何解决 PPO 的训练过程同时存在**4个模型(2训练,2**推理),对计算资源的要求较高 问题?
• 解决方法:训练过程改造派
• 方法介绍:该类方法通常通过改造模型的训练方式(如只保留SFT和RM),以提高训练效率并减少
训练成本。
• 代表方法:
\1. RAFT
RAFT(Reward rAnked FineTuning),它基于关于通过奖励和监督微调对样本进行排序的组合的形式。
\1. DPO
DPO(Direct Preference Optimization) 提出了一种使用二进制交叉熵目标来精确优化LLM的方法,以替代基于 RL
HF 的优化目标,从而大大简化偏好学习 pipeline。
RLHF的替代方案:The Wisdom of Hindsight Makes Language Models Better Instruction Followers HIR、DPO、ReST、RLAIF、

模块六:推理、量化与部署(4~5 篇)
推理两阶段:Prefill 与 Decoding
TTFT、TPOT、吞吐量
KV Cache 解决串行效率
解码策略:贪心搜索 vs 概率采样
温度、Top-k、Top-p
重复惩罚、长度惩罚
采样参数实战:Temperature、Top-p、Top-k 怎么调
低/中/高温度适用场景
分层过滤优先级
模型压缩四件套:剪枝、量化、蒸馏、紧凑网络
GPTQ、AWQ、INT8/INT4
QAT vs PTQ
推理框架:vLLM、SGLang、MindIE、Xinference
LightLLM、VLLM
昇腾 MindIE
推理
推理中的两种解码策略
- 基于贪心搜索策略
- 长度惩罚
- 重复惩罚
- 基于概率采样策略
- 温度采样
- top-k采样
- top-p采样
量化
| 技术方向 | 核心逻辑 | 通俗比喻 | 典型代表 |
|---|---|---|---|
| 1. 模型剪枝 | 瘦身:砍掉神经网络中不重要的连接或神经元。就像修剪树枝,去掉冗余部分,树冠变小但主干保留。 | 大规模裁员:留下关键骨干,裁掉对最终结果影响极小的边缘员工。 | 权重剪枝、结构化剪枝(如通道剪枝) |
| 2. 模型量化 | 降精度:将模型参数从高精度(如32位浮点数)转为低精度(如8位整数)。相当于把高清照片转为压缩格式,体积大减,肉眼看不出差别。 QAT、PTQ(静态、动态) |
压缩打包:把精装书变成口袋书,字变小了但内容完整可读。 | GPTQ、AWQ(大模型量化)、INT8/INT4 |
| 3. 知识蒸馏 | 师生传承:训练一个小的“学生模型”,去模仿大“教师模型”的软输出(概率分布)。学生学到的不仅是标准答案,还有老师的“思考逻辑”。 | 学霸笔记:老师(大模型)把毕生所学提炼成精华笔记,学生(小模型)只背笔记就能考高分。 | DistilBERT、TinyBERT |
| 4. 紧凑网络设计 | 天生小巧:不压缩现有模型,而是直接设计结构更高效的网络架构。 | 轻量化设计:不改造SUV,直接设计一款性能强大的迷你Cooper。 | MobileNet、ShuffleNet、SqueezeNet |
消融实验
推理:
Prefill阶段
- 根据输入Tokens生成第一个输出Token(A),通过一次Forward就可以完成
- 在Forward中,输入Token间可以并行执行,因此执行效率很高
Decoding阶段
- 从生成第一个Token后,采用自回归一次生成一个Token,直到生成Stop Token结束
- 设输出共N*Token,Decoding阶段需要执行N-1次Forward,只能串行执行,效率很低
- 在生成过程中,需要关注Token越来越多,计算量也会适当增大
- kv cache解决
vllm、sglang、mindIE(昇腾的)、xinference
首个词元生成时间(**Time To First Token,简称TTFT**):即用户输入查询后,模型生成第一个输出所需的
时间。在实时交互中,低时延获取响应非常重要,但在离线工作负载中则不太重要。此指标受处理提示信息
并生成首个输出词元所需的时间所驱动;
\2. 单个输出词元的生成时间(**Time Per Output Token,简称TPOT**):为每个查询系统的用户生成一个输出
词元所需的时间。这一指标与每个用户对模型“速度”的感知相关。例如,TPOT为100毫秒/词元表示每个用户
每秒可处理10个词元,或每分钟处理约450个词,这一速度远超普通人的阅读速度;
\3. 时延:模型为用户生成完整响应所需的总时间。整体响应时延可使用前两个指标计算得出:时延 =
(TTFT)+ (TPOT)*(待生成的词元数);
\4. 吞吐量:推理服务器在所有用户和请求中每秒可生成的输出词元数。
• 目标:以最短的时间生成首个词元、达到最高吞吐量以及在最短的时间内生成输出词元。
LightLLM、VLLM
公开的数据集:Huggle face、kaggle、dataset search、awesome-public-datasets、opendatalab、modelscope。 MDP生成数据集
EasyDataset(开源工具)
模块七:RAG 与 Agent(6~8 篇)
RAG 演进:Naive → Advanced → Modular
检索-读取模式
稠密嵌入、查询重写、重排序
文档切分 6 种方式:固定、递归、语义、结构、父子块、Meta-Chunking
- 各自适用场景与优缺点
8 种 RAG 类型:Naive、HyDE、Corrective、Self-RAG、Graph、Hybrid、Adaptive、Agentic
- 从基础到智能体 RAG
RAG 高效召回:多查询扩展、HyDE、MMR、RRF
MQE、RAG-Fusion
上下文压缩
知识图谱增强 RAG:LightRAG、GraphRAG、NL2Cypher
- 图采样、实体抽取
Agent 架构:感知、决策、行动
Plan and Executor
多轮对话改写
Agent 记忆系统:感觉记忆、工作记忆、长期记忆
语义记忆、情景记忆
Neo4j + Qdrant 混合架构
Agent 协议:MCP、A2A、ANP
MCP 与 Function Calling 的区别
JSON-RPC 请求响应格式
长时程 Agent:压缩整合、结构化笔记、子代理架构
Compaction、Structured note-taking
Sub-agent architectures
Agent 工具与框架:LangChain、LangGraph、LlamaIndex、AutoGen、CAMEL
- 工具调用、中间件、标准化输出
Agent

相似度:①余弦相似度(长度无关,只看角度)②欧氏距离(二维下就是勾股定理)③点积


文档切分方式总结
| 切分方式 | 核心原理 | 适用场景(结合你的关注点) | 优点 | 缺点 |
|---|---|---|---|---|
| 1. 固定大小分块 | 按固定字符/token数切割,设置重叠区域。 | 快速基线测试,对任何内容进行初步验证。 | 实现极其简单,处理速度快。 | 会切断句子和段落,语义完整性最差,不适合专业文档。 |
| 2. 递归分块 | 按段落、句子等不同层级依次尝试分割,直到块大小合适。 | 通用首选,特别适合一般叙事类书籍和结构不固定的文本。 | 比固定大小更智能,能较好地保留段落和句子边界。 | 无法理解主题或逻辑,仍可能切断逻辑连贯的段落。 |
| 3. 语义分块 | 计算句子向量相似度,在主题发生显著变化处切分。 | 课程大纲、主题跳跃明显的文档。 | 能保证每个块内部主题连贯,自然匹配大纲的“模块化”特性。 | 计算成本高,可能产生碎片化块,对逻辑关系(如因果)不敏感。 |
| 4. 结构分块 | 利用Markdown标题、HTML标签、PDF大纲等天然边界切分。 | 医案、技术手册、法律合同等强结构化文档。 | 块与文档章节对应,语义完整性和准确性最高,便于注入章节元数据。 | 依赖文档格式规范,格式混乱时效果差。 |
| 5. 父子块索引 | 检索用精确的子块(小粒度),答案取上下文丰富的父块(大粒度)。 | 复杂的书籍章节、详细的医案,需要兼顾检索精度和上下文完整度。 | 工业级方案,同时解决了“精准命中”和“信息充足”的矛盾。 | 实现复杂,需要维护块之间的父子关系,存储和检索成本略高。 |
| 6. Meta-Chunking | 利用LLM困惑度或边际采样,识别句子间的逻辑边界(如因果、转折)。 | 逻辑密集型学术书籍、推理链复杂的文档。 | 切分出的块是逻辑完整的“思想单元”,对复杂推理问题效果显著。 | 需要额外计算资源,对简单叙事或罗列性文本(如大纲)优势不明显。 |
https://blog.csdn.net/python12345_/article/details/159501030
这八种常见的RAG类型如下:
| 类型 (Type) | 核心思想 (Core Idea) | 对应你图片中的位置/方向 |
|---|---|---|
| 1. Naive RAG (基础RAG) | 最经典的“检索-生成”流程,先把文档拆成小块,再根据问题找最像的那几块,最后让大模型生成答案。 | 起点:图中最基础的层次。 |
| 2. HyDE (假设文档嵌入) | 让大模型先根据问题“想象”一个答案,再用这个假答案去文档库里找真正相关的信息,以提升检索准确率。 | 向上:提升检索的“智能程度”。 |
| 3. Corrective RAG (纠正式RAG) | 给生成的答案加一道“质检”环节。如果发现答案可能有问题,就自动去网上搜索纠正或补充信息。 | 向上:增加系统的“自我纠正”能力。 |
| 4. Self-RAG (自反思RAG) | 让模型自己学会“反省”。它会在生成答案时不断问自己“我需要查资料吗?”、“查到的资料有用吗?”,并据此调整行为。 | 向上:是迈向自主决策的一步。 |
| 5. Graph RAG (图谱RAG) | 不再把文档打散成碎片,而是构建一个像知识网络一样的“知识图谱”,能更好地理解概念之间的复杂关系。 | 向右:应对知识结构复杂度的提升。 |
| 6. Hybrid RAG (混合RAG) | “多管齐下”,同时使用向量检索、关键词匹配甚至知识图谱等多种方法去搜索,然后把结果汇总,搜得更全、更准。 | 向右:处理更复杂的知识结构。 |
| 7. Adaptive RAG (自适应RAG) | 像个聪明的管家,先判断一下问题简不简单。简单问题走快速通道,复杂问题才启动全套复杂检索流程,会动态调整策略。 | 接近右上角:兼具高智能和应对复杂结构的能力。 |
| 8. Agentic RAG (智能体RAG) | 最高阶的形态。它不是一个被动的检索工具,而是一个能自主规划、使用多种工具、甚至多“人”协作来完成复杂任务的AI智能体。 | 终点/右上角:代表系统智能程度的最高水平。 |
Multi-Head RAG(多角度理解)、SFR RAG
ARES RAG的评测
向量数据库进行上下文增强 存在问题:
无法获取长程关联知识
信息密度低(尤其当LLM context window较小时不友好)
利用知识图谱进行增强
具体方式:对于 用户 query,通过 利用 NL2Cypher 进行 KG 增强;
• 优化策略:常用 图采样技术来进行KG上下文增强
• 处理方式:根据query抽取实体,然后把实体作为种子节点对图进行采样(必要时,可把KG中节点和query中
实体先向量化,通过向量相似度设置种子节点),然后把获取的子图转换成文本片段,从而达到上下文增强的效果

RAG-Fusion 多查询生成? RRF逆向排名融合
RAG中MMR同时看查询与文档之间的相似度以及文档之间的相似度,可以最大边际相关搜索
RAG高效召回:
①离散索引扩展(关键词抽取,实体识别NER等)
②多重查询(大模型扩写问题,然后每个问题的答案取交集)
③上下文压缩(把第一次检索到的答案给大模型进行压缩)
④MMR和相似度打分
graphql是干什么的?
Skill 就是把提示词整合成一步一步的说明书(markdown)。一开始只加载名称和描述,而不加载详情
ralph使AI一直工作(是只能在claude code中吗?)
多轮对话改写
| 主题分类 | 核心目标 | 包含的Prompt技巧 |
|---|---|---|
| 1. 新任务学习 | 让模型在不经微调的情况下,仅通过提示学习并执行新任务。 | Zero-Shot Prompting (零样本提示) Few-Shot Prompting (少样本提示) |
| 2. 推理与逻辑 | 增强模型处理复杂逻辑、数学和符号推理任务的能力。 | Chain-of-Thought (CoT, 思维链) Automatic CoT (Auto-CoT, 自动思维链) Self-Consistency (自我一致性) Logical CoT (LogiCoT, 逻辑思维链) Chain-of-Symbol (CoS, 符号链) Tree-of-Thoughts (ToT, 思维树) Graph-of-Thoughts (GoT, 思维图) System 2 Attention (S2A, 系统2注意力) Thread of Thought (ThoT, 思维线程) Chain-of-Table (表格链) |
| 3. 减少幻觉 | 减少模型生成与事实不符或无依据内容的倾向,提高准确性。 | Retrieval Augmented Generation (RAG, 检索增强生成) ReAct Prompting (推理与行动) Chain-of-Verification (CoVe, 验证链) Chain-of-Note (CoN, 笔记链) |
| 4. 用户交互 | 通过更智能的提示策略,让模型主动获取用户有效反馈,提升交互效率。 | Active Prompting (主动提示) |
| 5. 微调与优化 | 利用机器学习方法自动发现和选择最优的提示策略。 | Automatic Prompt Engineer (APE, 自动提示工程师) |
| 6. 基于知识的推理与生成 | 使模型能整合外部知识库或使用外部工具,以完成更复杂的任务。 | Automatic Reasoning and Tool-use (ART, 自动推理与工具使用) |
| 7. 提升一致性与连贯性 | 通过对比正误示例,引导模型产生更准确、更连贯的推理。 | Contrastive CoT (CCoT, 对比思维链) |
| 8. 情绪与语气管理 | 通过在提示中加入情绪激励,提升模型在情感理解和创意任务上的表现。 | Emotion Prompting (情绪提示) |
| 9. 代码生成与执行 | 提升LLM生成、理解和执行代码的能力,特别是处理复杂算法问题。 | Scratchpad Prompting (草稿本提示) Program of Thoughts (PoT, 程序化思维) Structured CoT (SCoT, 结构化思维链) Chain-of-Code (CoC, 代码链) |
| 10. 优化与效率 | 利用LLM自身来寻找和优化解决问题的方案或提示词本身。 | Optimization by Prompting (OPRO, 通过提示进行优化) |
| 11. 理解用户意图 | 通过让模型先改写和扩写问题,更准确地理解用户模糊或复杂的意图。 | Rephrase and Respond (RaR, 改写与回应) |
| 12. 元认知与自我反思 | 引导模型进行高层面的抽象思考,从具体问题中提炼原则,以提升推理质量。 | Take a Step Back Prompting (后退一步提示) |
深入解读两类核心技巧
这些技巧各有侧重,但如果你想快速掌握最有代表性的方法,可以重点关注以下两类:
1. 推理能力的基石:思维链 (CoT) 及其进化
CoT (思维链) 是这个领域的核心突破,它通过要求模型“一步步思考”,极大地提升了复杂推理的准确率。书中后续的许多技巧,比如 ToT (思维树) 和 GoT (思维图),都是在CoT基础上的进化,它们分别引入了“树状探索”和“图状连接”的复杂推理结构,让模型的思考过程更接近人类,更善于处理需要深度规划或回溯的问题。
2. 准确性的保障:RAG 与 ReAct
为了减少模型“胡说八道”(幻觉)的问题,RAG (检索增强生成) 是目前业界最主流的解决方案。它让模型在回答前先去一个可靠的知识库里“查资料”,基于事实来回答,极大地提高了内容的准确性。而 ReAct 则更进一步,它让模型不仅能“想”(Reason),还能“做”(Act),比如调用外部工具或API来获取实时信息,这使得模型能够处理需要与环境互动的复杂任务。

知识图谱 lightRag/GraphRag/graphliti/autom
agent:anthropic仓库cloude-quickstarts的五个项目(逐个递进 Agent->Customer support-> Finnncial Analyst->computer use -> autonomous coding)、ChatDev、AgentGPT(已停止维护)、AutoGPT、transfermers agents(smolagents)、BabyAGI(业余项目,只是想法和讨论,不可直接用于生产环境)、GPT-Engineer(归档了,停止维护了)、MetaGPT(也一年没更新了)、MindOS(https://mindos.you/#quickstart)、chemCrow(LLM+化学)、AutoGen(微软停止维护了,转而使用商业化的MAF)、AgentScope、camel(https://github.com/camel-ai/camel)、HelloAgent可以用来学习、fastGpt、langChain(agent builder)/langGraph、Qodo Cover测试、llamaindex(RAG的王者)、Qwen Agent
langchain1.x版本吧后续可能会删掉的放到了classic中
langchain中间件middleware(摘要总结、人机交互、重试tool、自定义)
标准化输出 content_block
结构化输出 json结构
长上下文时模型会丢失中间内容,对于头尾会处理的更好些。langchain中有longcontext的处理,将向量化获取的数据进行头尾处理
langchain中有对向量化缓存的操作
工具:BochaAI(网络搜索)、Brave API(国外的网络搜索)、llamahub仓库、FlowiseAI(工作流可视化)支持langchain和llamaindex
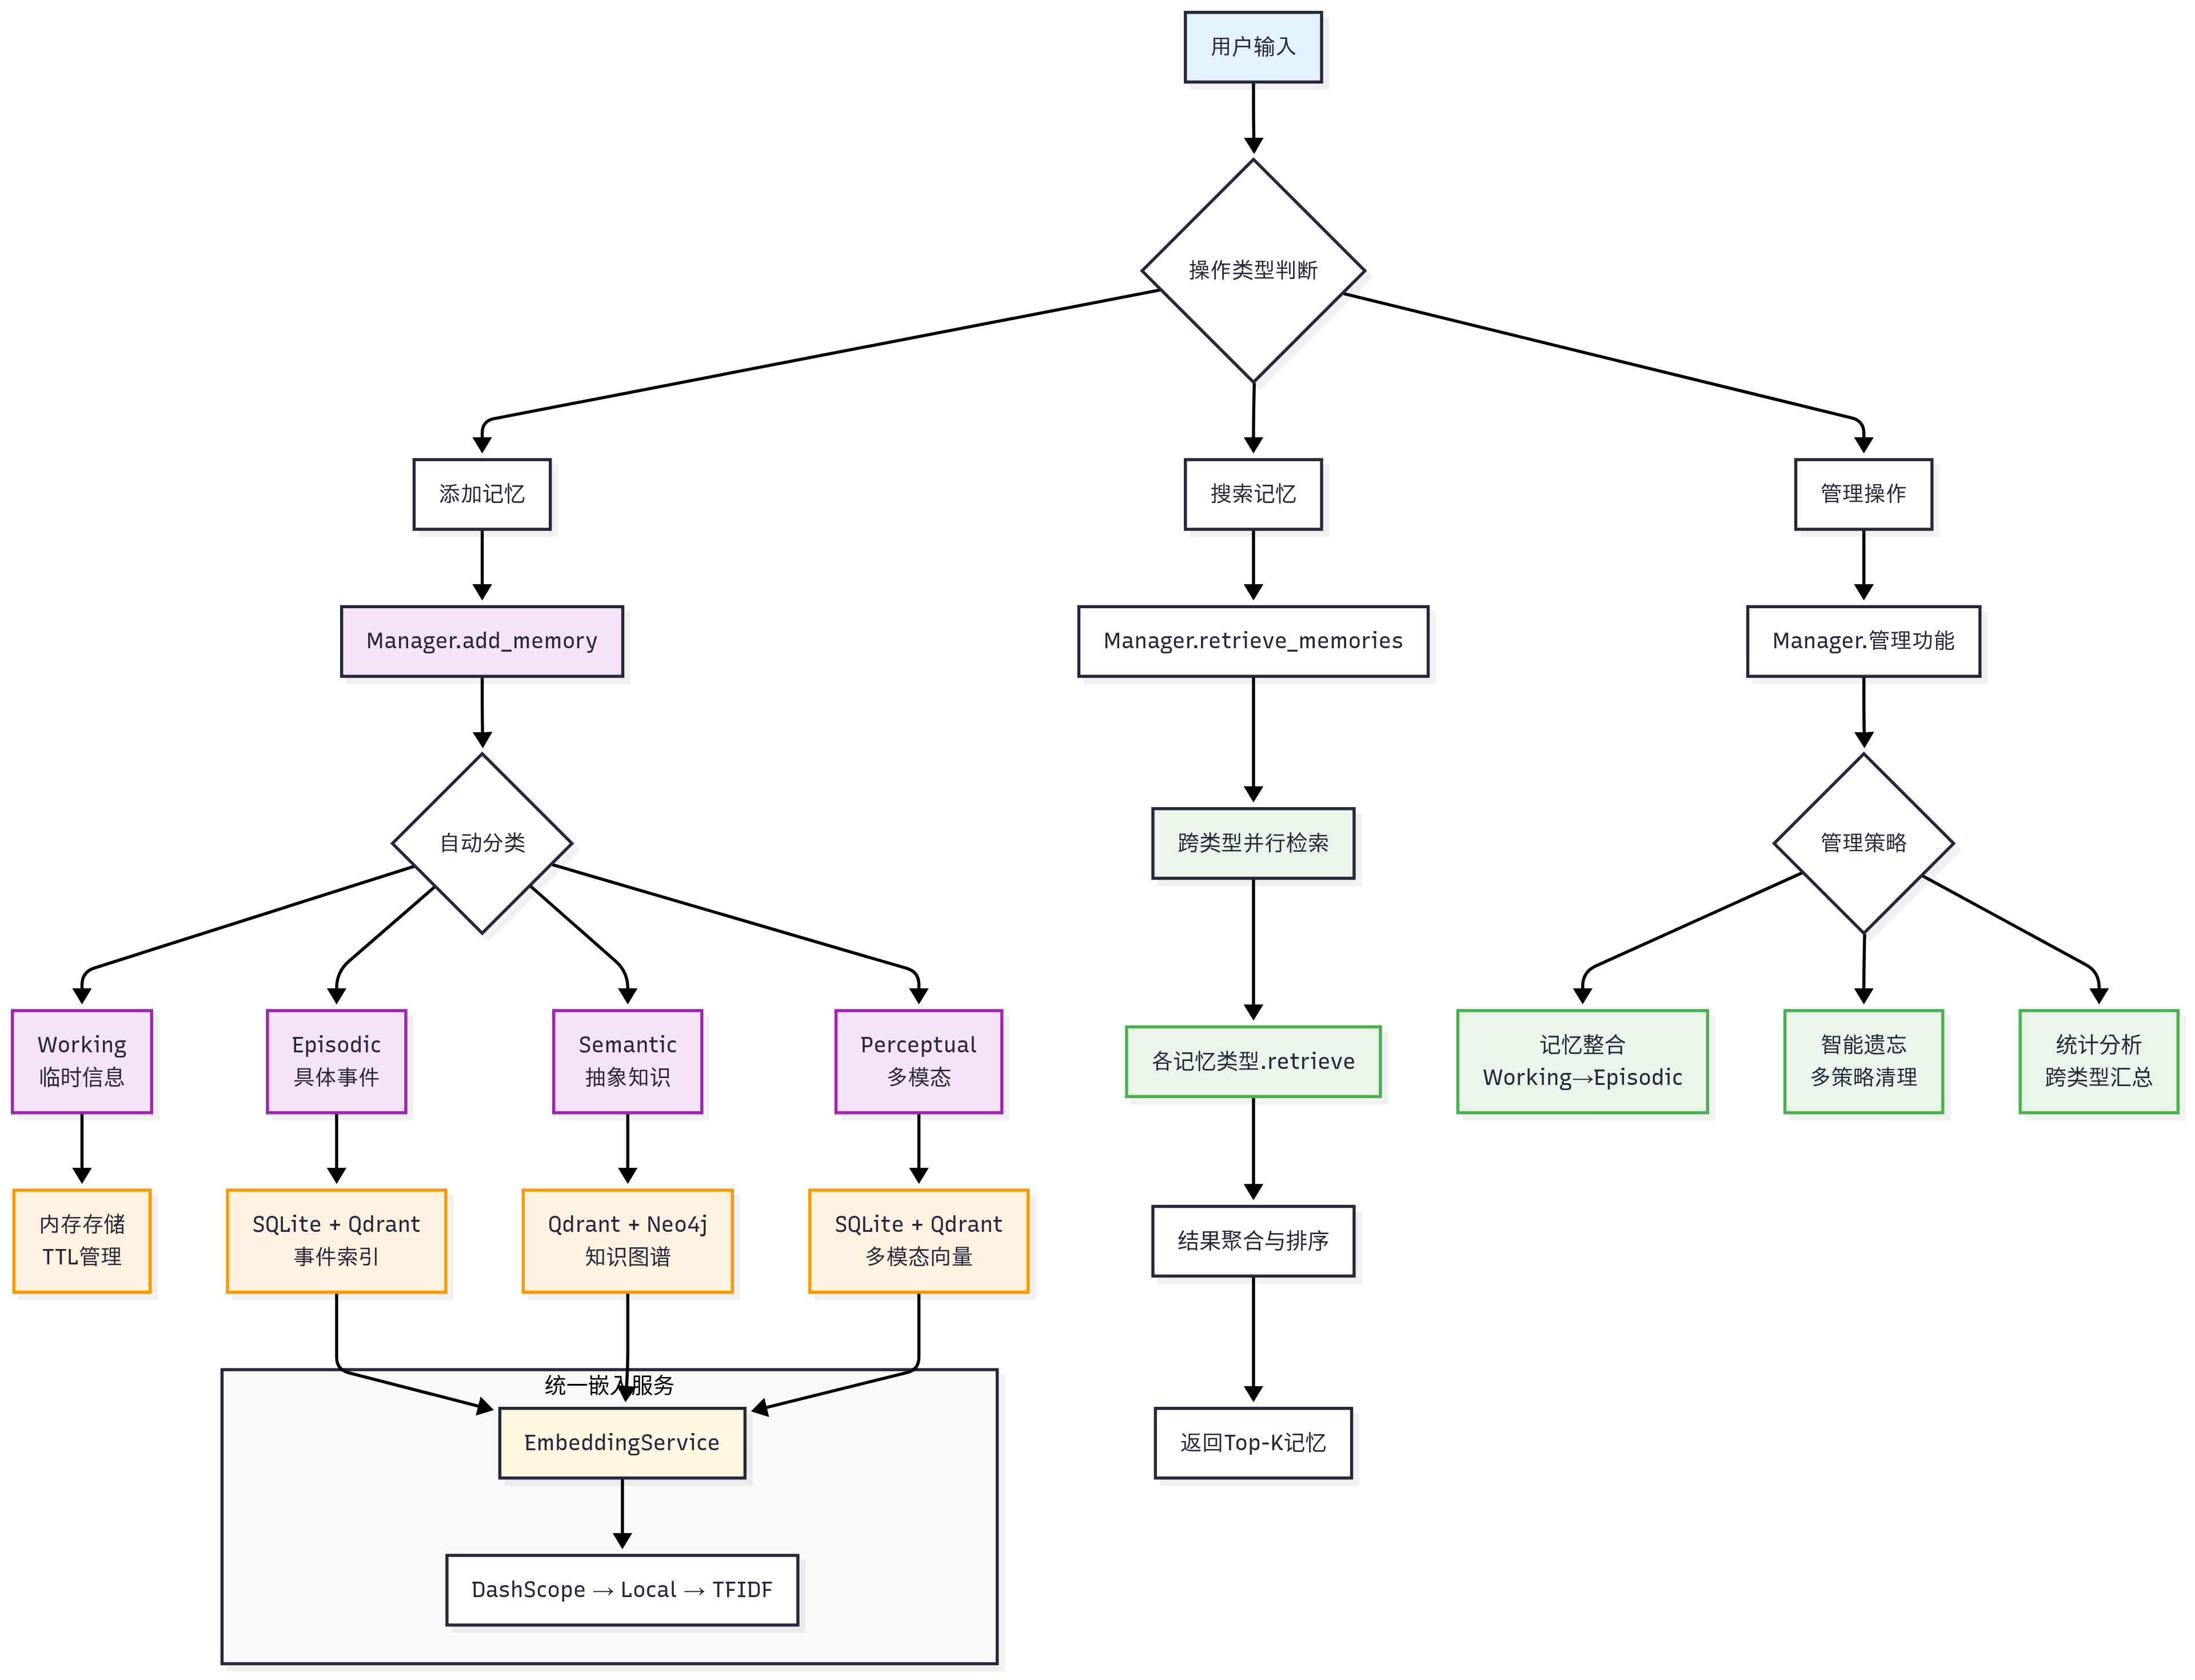
感觉记忆(Sensory Memory):持续时间极短(0.5-3秒),容量巨大,负责暂时保存感官接收到的所有信息。感知记忆支持文本、图像、音频等多种模态的数据存储和检索。它采用了模态分离的存储策略,为不同模态的数据创建独立的向量集合,这种设计避免了维度不匹配的问题,同时保证了检索的准确性
工作记忆(Working Memory):持续时间短(15-30秒),容量有限(7±2个项目),负责当前任务的信息处理。工作记忆采用了纯内存存储方案,配合TTL(Time To Live)机制进行自动清理。这种设计的优势在于访问速度极快,但也意味着工作记忆的内容在系统重启后会丢失。这种特性正好符合工作记忆的定位,存储临时的、易变的信息。
工作记忆采用组合词法检索策略:使用 TF-IDF 将文本表示为稀疏词项向量并计算词法相似度,同时结合关键词匹配;当 TF-IDF 不可用或未产生有效得分时,则使用关键词得分。TF-IDF 的向量化表示来自词频和逆文档频率,并不等同于基于稠密嵌入的语义检索。评分算法结合了词法相关性、时间衰减和重要性权重,最终得分公式为:
(相关性 × 时间衰减) × (0.8 + 重要性 × 0.4)。长期记忆(Long-term Memory):持续时间长(可达终生),容量几乎无限,进一步分为:
程序性记忆:技能和习惯(如骑自行车)
陈述性记忆:可以用语言表达的知识,又分为:
语义记忆:一般知识和概念(如”巴黎是法国首都”)。语义记忆是记忆系统中最复杂的部分,它负责存储抽象的概念、规则和知识。语义记忆的设计重点在于知识的结构化表示和智能推理能力。语义记忆采用了Neo4j图数据库和Qdrant向量数据库的混合架构,这种设计让系统既能进行快速的语义检索,又能利用知识图谱进行复杂的关系推理。
语义记忆的评分公式为:
(向量相似度 × 0.7 + 图相似度 × 0.3) × (0.8 + 重要性 × 0.4)。这种设计的核心思想是:- 向量检索权重(0.7):语义相似度是主要因素,确保检索结果与查询语义相关
- 图检索权重(0.3):关系推理作为补充,发现概念间的隐含关联
- 重要性权重范围[0.8, 1.2]:避免重要性过度影响相似度排序,保持检索的准确性
情景记忆:个人经历和事件(如”昨天的会议内容”)。情景记忆负责存储具体的事件和经历,它的设计重点在于保持事件的完整性和时间序列关系。情景记忆采用了SQLite+Qdrant的混合存储方案,SQLite负责结构化数据的存储和复杂查询,Qdrant负责高效的向量检索。
情景记忆的检索实现展现了复杂的多因素评分机制。它不仅考虑了语义相似度,还加入了时间近因性的考量,最终通过重要性权重进行调节。评分公式为:
(向量相似度 × 0.8 + 时间近因性 × 0.2) × (0.8 + 重要性 × 0.4),确保检索结果既语义相关又时间相关。
plan and executor:Agent(感知环境、分析决策、采取行动、实现目标)
第一阶段:朴素RAG(Naive RAG, 2020-2021)。这是RAG技术的萌芽阶段,其流程直接而简单,通常被称为“检索-读取”(Retrieve-Read)模式。检索方式:主要依赖传统的关键词匹配算法,如TF-IDF或BM25。这些方法计算词频和文档频率来评估相关性,对字面匹配效果好,但难以理解语义上的相似性。生成模式:将检索到的文档内容不加处理地直接拼接到提示词的上下文中,然后送给生成模型。
第二阶段:高级RAG(Advanced RAG, 2022-2023)。随着向量数据库和文本嵌入技术的成熟,RAG进入了快速发展阶段。研究者和开发者们在“检索”和“生成”的各个环节引入了大量优化技术。检索方式:转向基于稠密嵌入(Dense Embedding)的语义检索。通过将文本转换为高维向量,模型能够理解和匹配语义上的相似性,而不仅仅是关键词。生成模式:引入了很多优化技术,例如查询重写,文档分块,重排序等。
第三阶段:模块化RAG(Modular RAG, 2023-至今)。在高级RAG的基础上,现代RAG系统进一步向着模块化、自动化和智能化的方向发展。系统的各个部分被设计成可插拔、可组合的独立模块,以适应更多样化和复杂的应用场景。检索方式:如混合检索,多查询扩展,假设性文档嵌入等。生成模式:思维链推理,自我反思与修正等。
多查询扩展(MQE)
多查询扩展(Multi-Query Expansion)是一种通过生成语义等价的多样化查询来提高检索召回率的技术。这种方法的核心洞察是:同一个问题可以有多种不同的表述方式,而不同的表述可能匹配到不同的相关文档。例如,”如何学习Python”可以扩展为”Python入门教程”、”Python学习方法”、”Python编程指南”等多个查询。通过并行执行这些扩展查询并合并结果,系统能够覆盖更广泛的相关文档,避免因用词差异而遗漏重要信息
假设文档嵌入(HyDE)
假设文档嵌入(Hypothetical Document Embeddings,HyDE)是一种创新的检索技术,它的核心思想是”用答案找答案”。传统的检索方法是用问题去匹配文档,但问题和答案在语义空间中的分布往往存在差异——问题通常是疑问句,而文档内容是陈述句。HyDE通过让LLM先生成一个假设性的答案段落,然后用这个答案段落去检索真实文档,从而缩小了查询和文档之间的语义鸿沟。
记忆(上下文) :保存context->选择context->压缩context->隔离context
长时程任务要求智能体在超出上下文窗口的长序列行动中,仍能保持连贯性、上下文一致与目标导向。例如大型代码库迁移、跨数小时的系统性研究。指望无限增大上下文窗口并不能根治“上下文污染”与相关性退化的问题,因此需要直接面向这些约束的工程手段:压缩整合(Compaction)、结构化笔记(Structured note-taking)与子代理架构(Sub-agent architectures)。
压缩整合(Compaction)
- 定义:当对话接近上下文上限时,对其进行高保真总结,并用该摘要重启一个新的上下文窗口,以维持长程连贯性。
- 实践:让模型压缩并保留架构性决策、未解决缺陷、实现细节,丢弃重复的工具输出与噪声;新窗口携带压缩摘要 + 最近少量高相关工件(如“最近访问的若干文件”)。
- 调参建议:先优化召回(确保不遗漏关键信息),再优化精确度(剔除冗余内容);一种安全的“轻触式”压缩是对“深历史中的工具调用与结果”进行清理。
保留第一轮对话以及最近N轮,中间的进行压缩总结(短时记忆),如果对于长期记忆,可能今天聊这个,明天聊那个,会误导模型。如果在推理时模型的参数也可以改变的话,就可以实现模型的长期记忆。但是模型又不是一个人使用
结构化笔记(Structured note-taking)
- 定义:也称“智能体记忆”。智能体以固定频率将关键信息写入上下文外的持久化存储,在后续阶段按需拉回。
- 价值:以极低的上下文开销维持持久状态与依赖关系。例如维护 TODO 列表、项目 NOTES.md、关键结论/依赖/阻塞项的索引,跨数十次工具调用与多轮上下文重置仍能保持进度与一致性。
- 说明:在非编码场景中同样有效(如长期策略性任务、游戏/仿真中的目标管理与统计计数)。结合第八章的
MemoryTool,可轻松实现文件式/向量式的外部记忆并在运行时检索。
子代理架构(Sub-agent architectures)
- 思想:由主代理负责高层规划与综合,多个专长子代理在“干净的上下文窗口”中各自深挖、调用工具并探索,最后仅回传凝练摘要(常见 1,000–2,000 tokens)。
- 好处:实现关注点分离。庞杂的搜索上下文留在子代理内部,主代理专注于整合与推理;适合需要并行探索的复杂研究/分析任务。
- 经验:公开的多智能体研究系统显示,该模式在复杂研究任务上相较单代理基线具有显著优势。
方法取舍可以遵循以下经验法则:
- 压缩整合:适合需要长对话连续性的任务,强调上下文的“接力”。
- 结构化笔记:适合有里程碑/阶段性成果的迭代式开发与研究。
- 子代理架构:适合复杂研究与分析,能从并行探索中获益。
命令行工具,进行命令白名单、工作目录限制、超时控制、输出大小限制
智能体协议:
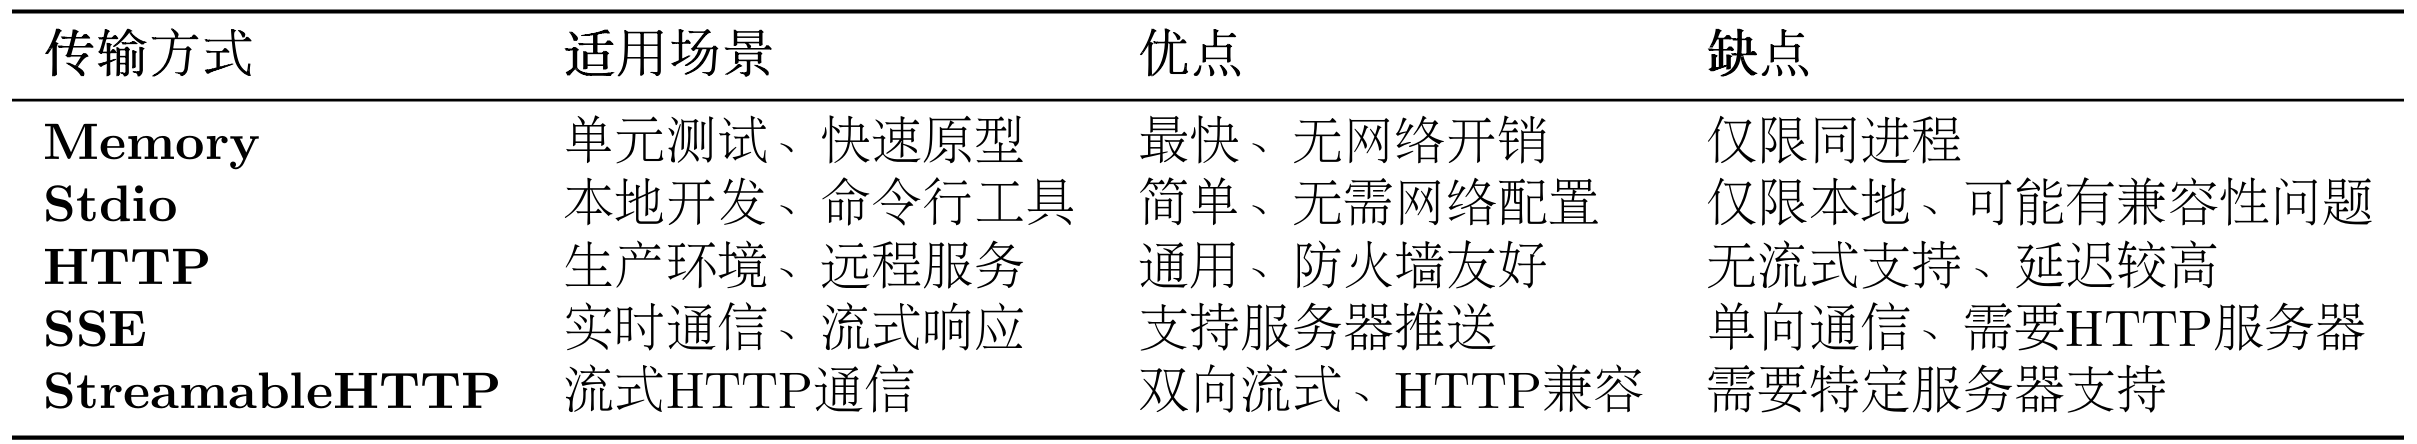
MCP协议:智能体与工具的桥梁
MCP(Model Context Protocol)由 Anthropic 团队提出[1],其核心设计理念是标准化智能体与外部工具/资源的通信方式。想象一下,你的智能体需要访问文件系统、数据库、GitHub、Slack 等各种服务。传统做法是为每个服务编写专门的适配器,这不仅工作量大,而且难以维护。MCP 通过定义统一的协议规范,让所有服务都能以相同的方式被访问。
MCP 的设计哲学是”上下文共享”。它不仅仅是一个 RPC(远程过程调用)协议,更重要的是它允许智能体和工具之间共享丰富的上下文信息。如图 10.1 所示,当智能体访问一个代码仓库时,MCP 服务器不仅能提供文件内容,还能提供代码结构、依赖关系、提交历史等上下文信息,让智能体能够做出更智能的决策
A2A协议:智能体间的对话
A2A(Agent-to-Agent Protocol)协议由 Google 团队提出2,其核心设计理念是实现智能体之间的点对点通信。与 MCP 关注智能体与工具的通信不同,A2A 关注的是智能体之间如何相互协作。这种设计让智能体能够像人类团队一样进行对话、协商和协作。
A2A 的设计哲学是”对等通信”。如图 10.2 所示,在 A2A 网络中,每个智能体既是服务提供者,也是服务消费者。智能体可以主动发起请求,也可以响应其他智能体的请求。这种对等的设计避免了中心化协调器的瓶颈,让智能体网络更加灵活和可扩展。
ANP:智能体网络的基础设施
ANP(Agent Network Protocol)是一个概念性的协议框架3,目前由开源社区维护,还没有成熟的生态,其核心设计理念是构建大规模智能体网络的基础设施。如果说 MCP 解决的是”如何访问工具”,A2A 解决的是”如何与其他智能体对话”,那么 ANP 解决的是”如何在大规模网络中发现和连接智能体”。
ANP 的设计哲学是”去中心化服务发现”。在一个包含成百上千个智能体的网络中,如何让智能体能够找到它需要的服务?如图 10.3 所示,ANP 提供了服务注册、发现和路由机制,让智能体能够动态地发现网络中的其他服务,而不需要预先配置所有的连接关系。
MCP:
请求和响应格式 jsonrpc 详细格式?
请求
{
  "jsonrpc": "2.0",
  "id": "string | number",
  "method": "string",
  "params": {
    "[key: string]": "unknown"
  }
}
响应
{
  "jsonrpc": "2.0",
  "id": "string | number",
  "result": {
    "[key: string]": "unknown"
  },
  "error": {
    "code": "number",
    "message": "string",
    "data": "unknown"
  }
}
当用户提出问题时,完整的工具选择流程如下:
工具发现阶段:MCP Client 连接到 Server 后,首先调用
list_tools()获取所有可用工具的描述信息(包括工具名称、功能说明、参数定义)上下文构建:Client 将工具列表转换为 LLM 能理解的格式,添加到系统提示词中。例如:
你可以使用以下工具: - read_file(path: str): 读取指定路径的文件内容 - search_code(query: str, language: str): 在代码库中搜索Copy to clipboardErrorCopied模型推理:LLM 分析用户问题和可用工具,决定是否需要调用工具以及调用哪个工具。这个决策基于工具的描述和当前对话上下文
工具执行:如果 LLM 决定使用工具,Client 通过 MCP Server 执行所选工具,获取结果
结果整合:工具执行结果被送回给 LLM,LLM 结合结果生成最终回答
这个过程是完全自动化的,LLM 会根据工具描述的质量来决定是否使用以及如何使用工具。因此,编写清晰、准确的工具描述至关重要。
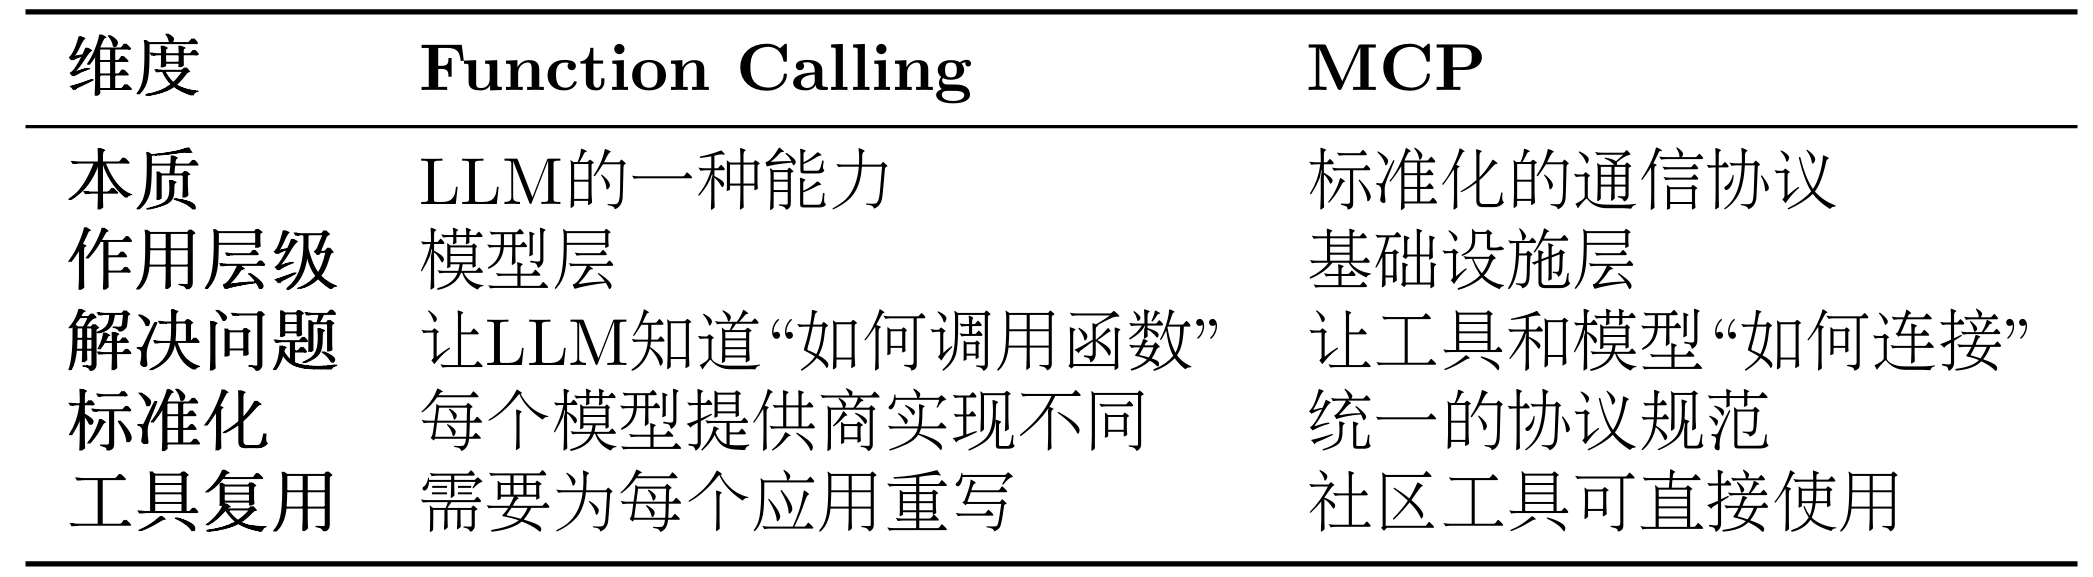
(5)MCP 与 Function Calling 的差异
很多开发者会问:我已经在用 Function Calling 了,为什么还需要 MCP? 让我们通过表 10.3 来理解它们的区别。
表 10.3 Function Calling 与 MCP 对比
这里我们以智能体需要访问 GitHub 仓库和本地文件系统为例子来详细对比同一个任务的两种实现
方式 1:使用 Function Calling
# 步骤1:为每个LLM提供商定义函数
# OpenAI格式
openai_tools = [
    {
        "type": "function",
        "function": {
            "name": "search_github",
            "description": "搜索GitHub仓库",
            "parameters": {
                "type": "object",
                "properties": {
                    "query": {"type": "string", "description": "搜索关键词"}
                },
                "required": ["query"]
            }
        }
    }
]

# Claude格式
claude_tools = [
    {
        "name": "search_github",
        "description": "搜索GitHub仓库",
        "input_schema": {  # 注意:不是parameters
            "type": "object",
            "properties": {
                "query": {"type": "string", "description": "搜索关键词"}
            },
            "required": ["query"]
        }
    }
]

# 步骤2:自己实现工具函数
def search_github(query):
    import requests
    response = requests.get(
        "https://api.github.com/search/repositories",
        params={"q": query}
    )
    return response.json()

# 步骤3:处理不同模型的响应格式
# OpenAI的响应
if response.choices[0].message.tool_calls:
    tool_call = response.choices[0].message.tool_calls[0]
    result = search_github(**json.loads(tool_call.function.arguments))

# Claude的响应
if response.content[0].type == "tool_use":
    tool_use = response.content[0]
    result = search_github(**tool_use.input)Copy to clipboardErrorCopied
方式 2:使用 MCP
from hello_agents.protocols import MCPClient

# 步骤1:连接到社区提供的MCP服务器(无需自己实现)
github_client = MCPClient([
    "npx", "-y", "@modelcontextprotocol/server-github"
])

fs_client = MCPClient([
    "npx", "-y", "@modelcontextprotocol/server-filesystem", "."
])

# 步骤2:统一的调用方式(与模型无关)
async with github_client:
    # 自动发现工具
    tools = await github_client.list_tools()

    # 调用工具(标准化接口)
    result = await github_client.call_tool(
        "search_repositories",
        {"query": "AI agents"}
    )

# 步骤3:任何支持MCP的模型都能使用
# OpenAI、Claude、Llama等都使用相同的MCP客户端Copy to clipboardErrorCopied
首先需要明确的是,Function Calling 与 MCP 并非竞争关系,而是相辅相成的。Function Calling 是大语言模型的一项核心能力,它体现了模型内在的智能,使模型能够理解何时需要调用函数,并精准生成相应的调用参数。相对地,MCP 则扮演着基础设施协议的角色,它在工程层面解决了工具与模型如何连接的问题,通过标准化的方式来描述和调用工具。
我们可以用一个简单的类比来理解:Function Calling 相当于你学会了“如何打电话”这项技能,包括何时拨号、如何与对方沟通、何时挂断。而 MCP 则是那个全球统一的“电话通信标准”,确保了任何一部电话都能顺利地拨通另一部
A2A
Agent、subAgent,主要就是做了上下文隔离而已
DeepResearch是什么?怎么个结构,多智能体开发
gstack/Multica/hermes
进阶
MOE在原来的FFN层上,激活专家数量、总专家数量。Deepseek在原来的MOE架构中加入了共享专家
混合专家架构MOE?中间有个路由,去判断该由哪个专家去处理
关于如何保证Router均衡地路由到不同专家,这个问题问得非常棒!业界通用的做法是引入负载均衡损失(Load Balancing Loss)。以DeepSeek模型为例,会在训练的Loss函数中加入一个辅助项,监控每个专家的使用频率。当一个专家被分配了过多的token时,它产生的惩罚Loss就会变大。这样在反向传播更新权重时,Router就会调整自身的网络参数,避免过度依赖该专家,强制将token均衡分配给其他专家。
Deepseek 开源的几个项目、llama开源项目
mabma架构?
微调所需要的硬件怎么计算,dense、moe
多机多卡如何进行训练
flash Attention(优化版的self-Attention),计算快(数据传输的优化),节省显存,精准注意力
Deepspeed(微软开发,提高大规模训练效率。
1.加速训练手段:数据并行(zero系列)、模型并行(PP)、梯度累积、动态缩放、混合精度等
2.辅助工具:分布式训练管理、内存优化和模型压缩等
3.快速迁移:通过python wrap方式基于pytorch,直接调用完成简单迁移
)、Megatron-LM(NVIDIA开发,提高大模型分布式并行训练效率和线性度
1.加速训练手段(分布式训练):综合数据并行(Data Parallelism),张量并行(Tensor Parallelism)、流水线并行(Pipeline Parallelism)
2.辅助工具:强大的数据处理、Tokenizer、支持LLM、VLM等基于Transformer结构
)
训练时有3个参数 weights(2bytes)+gradicuts(2bytes)+optimizer status(2 bytes)
Zero1:只对optimizer status进行切分,放到多个卡中,占用内存原始1/4
Zero2:对optimizer和grad进行切分,放到多个卡中,占用内存原始1/8
Zero3:对optimizer、grad和模型参数进行切分,放到多个卡中,内存与数据并行线性关系,通信DP1.5X
如何进行多机训练
图像进行稀疏编码
多模态模型如何进行微调?投影层(投影层负责把图像翻译成文字)
长上下文的难点在哪?GQA优化,分组注意力
1M的长上下文时如何做到的,计算量不会大吗
大模型怎么解析图片(VIT) 用的是编码器?
kimi提出注意力残差
文生图是怎么实现的?扩散模型?DiT 损失函数是计算噪音的差异,预测噪音


算子优化?
研究模型内部
①模型内部可视化
BertViz 注意力可视化
Transformers Interpret 注意力可视化,还可以定位幻觉。不支持qwen,要用captum
②高位数据与隐藏状态分析 PCA、UMAP
③综合分析
LIT(Language Interpretability Tool)
Embeding Atlas
模块八:行业大模型与推荐系统(4~5 篇)
推荐系统:召回、粗排、精排、重排
Wide&Deep → DeepFM → DCN-V2 → AutoInt
LLM 生成语义特征
CTR 预测实战:从 TFRecord 到模型部署
- 特征配置、训练方式、模型管理
AlphaFold2 与后来者:结构预测 vs 功能预测
AlphaFold3、D-I-TASSER、ESMFold、FiveFold
GraphDTA、TransformerCPI、EviDTI
行业大模型:ChatLaw、Galactica、MIMIC-III
- 法律、科学、医疗数据与训练
多模态与文生图:ViT、投影层、扩散模型、DiT
图像稀疏编码
多模态微调
推荐系统
推荐系统:召回、粗排、精排、重排
wide&deep模型:深度学习模型来进行推荐系统的CTR预测。是2016年谷歌提出的模型,它由“线性记忆部分(Wide)”和“DNN泛化部分(Deep)”简单拼接而成。它的“Wide”部分需要人工手动设计交叉特征,非常依赖工程师的经验
当前主流使用 DeepFM / DCN-V2 / xDeepFM / AutoInt,甚至引入大模型(LLM)生成语义特征
import math
import numpy as np
import pandas as pd
import sys
import os
sys.path.append(os.path.dirname(os.path.dirname(os.path.realpath(__file__))))
import tensorflow as tf
from utils import HdfsFile
from tensorflow import keras
from tensorflow.keras import layers
from model.DeepWideModel import DeepWideModel
def get_dataset_from_tfrecord(file_path, batch_size, feature_conf, num_epochs, shuffle=False):
    feature_schema = {}
    for item in feature_conf['features']:
        #print (item)
        item_type, default_value = (tf.float32, 0) if item['type'] == 'NUMERIC' else (tf.string, "none")
        feature_schema[item['name']] = tf.io.FixedLenFeature(shape=(1,), dtype=item_type, default_value=default_value)
    feature_schema[feature_conf['label']['name']] = tf.io.FixedLenFeature(shape=(1,), dtype=tf.float32, default_value=0)
    dataset = tf.data.experimental.make_batched_features_dataset(
        file_path,
        features=feature_schema,
        batch_size=batch_size,
        label_key=feature_conf['label']['name'],
        num_epochs=num_epochs,
        shuffle=shuffle,
    )
    return dataset.cache()
#load feature config

path = "/data/ctr/conf/20241126_feature.conf"
hdfs_path = f"hdfs://192.168.1.220:9000{path}"
feature_conf = HdfsFile.loadFeatureConf(hdfs_path)

train_data_file = "hdfs://192.168.1.220:9000/data/ctr/sample/20241126.tfrecord/*"
model_path = "hdfs://192.168.1.220:9000/data/ctr/model/20241126.model.real"
batch_size = 32
num_epochs = 1

train_dataset = get_dataset_from_tfrecord(train_data_file, batch_size, feature_conf, num_epochs, shuffle=False)
it = train_dataset.as_numpy_iterator()
i = 0
for element in it:
    #if i > 10:
    #    break
    i = i + 1
    #print ("123123123")
    print(len(list(it)))
    break
model = DeepWideModel()
features = feature_conf['features']
model.create(features)
model.train(train_dataset, num_epochs)
model.save(model_path)
predict_res = model.predict(train_dataset)

for element in predict_res[:50,:]:
    print(element[0])
    if element[0] > 0.5:
print(','.join(["%.6f" % number for number in element]))- 问题:Wide&Deep 是2016年谷歌提出的模型,它由“线性记忆部分(Wide)”和“DNN泛化部分(Deep)”简单拼接而成。它的“Wide”部分需要人工手动设计交叉特征,非常依赖工程师的经验。
- 现在的做法:业界早已进化到 DeepFM、DCN(Deep & Cross Network)、xDeepFM 等模型,它们用 FM 或 Cross层 自动替代了Wide部分的人工特征工程,效果更好且省力。近两年,Transformer-based 的模型(如 AutoInt、FiBiNet)以及引入 多模态/大模型语义 的方案更是进一步拉高了效果上限。
2. 数据处理:使用 make_batched_features_dataset
- 问题:这个API是TF 1.x 风格的老接口,比较底层,需要手动维护特征schema,扩展性差,也不方便做复杂的特征工程(如时序特征、序列行为特征)。
- 现在的做法:主流都已转向 TF Records + tf.data pipeline 自定义解析,或者直接使用 PyTorch 生态(尤其在研究界)。即使仍用TF,也会使用
tf.feature_column或 Keras 的PreprocessingLayer来做更规范的特征处理。
3. 训练方式:单机单卡,batch_size=32
- 问题:
num_epochs=1且 batch_size 很小,这在工业级海量数据下几乎不可能收敛到好效果。 - 现在的做法:大规模训练普遍使用 分布式训练(如 Horovod、TF分布式策略),配合 更大的batch size(如512~4096),并采用 学习率warmup + 自适应优化器(如AdamW、LAMB) 来保证训练稳定。
4. 特征配置:静态配置文件 20241126_feature.conf
- 问题:特征配置写死在文件中,每次新增/修改特征都需要重新发布配置,缺乏灵活性。
- 现在的做法:现代化的CTR系统会配合 Feature Store(如Feast、Tecton) 或 动态特征计算引擎,支持特征实时计算和在线/离线统一。
5. 模型保存与预测:使用HDFS直接存模型文件
- 问题:这种“存一个文件”的方式,在大规模线上服务时缺乏版本管理、A/B测试和回滚能力。
- 现在的做法:通常会结合 模型管理平台(如MLflow、Kubeflow),记录模型版本、训练指标、数据血缘,并与线上推理引擎(如TensorFlow Serving、TorchServe)联动。
行业大模型

MIMIC-III [432] 是目前被广泛使用的电子病历数据集,共包括 40K 余名病人的健康数据,覆盖医生诊断、生命体征测量、医学影像、生理数据、治疗方案、药物记录等信息
AlphaFold2
对于AlphaFold2这座里程碑,后来者确实在多个维度上实现了超越,但这个过程更像是一场多方向、渐进式的“接力赛”,而非单一革命性的“颠覆”。AlphaFold2依然是重要的性能基准,但已不再是唯一的顶点。
主要竞争者的超越路径
后来的挑战者主要在以下几个方向取得了明确的突破:
全能型继任者:AlphaFold3:作为AlphaFold2的官方迭代,它在CASP16等独立评估中,对蛋白质单体的预测精度(平均GDT_TS达87.1)略优于AlphaFold2(约85.5),并在蛋白质复合物、多肽-蛋白质、抗原-抗体等复杂相互作用的预测上展现出显著优势,还能扩展到DNA、RNA等非蛋白质分子的建模。不过其优势在某些情况下会因AlphaFold2加大“采样计算量”而被抹平。
精度挑战者:D-I-TASSER与DeepProteinNet:
- D-I-TASSER:在无模板可用的困难目标预测上表现出色,在一项基准测试中,对“硬”蛋白的平均模板建模(TM)得分达到0.870,比AlphaFold2的0.829高出约5%,在84%的测试目标上表现更好。
- DeepProteinNet:据称在低序列相似性(<30%)的蛋白预测上平均TM得分达0.79,优于AlphaFold2,同时推理时间比AlphaFold2快62%。
速度与状态采样挑战者:ESMFold与FiveFold:
- ESMFold:基于大语言模型,无需多序列比对(MSA),预测速度比AlphaFold2快10-30倍,适合大规模数据处理。但精度上仍与AlphaFold2有差距。
- FiveFold:这是一个集成预测器,通过采样子集和生成多种构象,能预测AlphaFold2无法捕捉的蛋白质动态构象,模拟出多达10种不同状态,并因此找到更多药物结合位点。
超越并非全方位:AlphaFold2优势仍在
在不少特定场景下,AlphaFold2的“老将”地位依然稳固。例如,在一项针对1666个新近解析的单体蛋白的基准测试中,AlphaFold2与AlphaFold3的准确率(约88%)相当,且显著高于ESMFold(76%)。对于许多常规蛋白质,AlphaFold2的预测精度依然是顶尖水平。
总结:选择取决于你的需求
如今的选择更像是一种权衡,而非简单的好坏比较:
- 追求极致精度与复合体预测:AlphaFold3 是首选,但需注意其在某些困难目标上优势不明显。
- 应对无模板的困难目标:可以尝试 D-I-TASSER。
- 需要高速处理海量数据:ESMFold 的高效优势突出。
- 研究蛋白质的动态构象:FiveFold 这类能捕捉多种状态的方法更有价值。
这些工具和AlphaFold2虽然都围绕药物-靶点相互作用(DTI)这个核心问题,但解决的是完全不同的子问题,处在药物发现流程的不同环节。简单来说,它们更像是AlphaFold2的下游应用工具,而非竞争对手。
我将它们和AlphaFold2的关系总结在了下面的表格里:
| 工具/模型 | 核心任务 (它预测什么) | 输入数据 (它从什么学) | 与AlphaFold2的关系 |
|---|---|---|---|
| AlphaFold2 | 预测蛋白质的静态三维结构 | 蛋白质的氨基酸序列 | 基础蓝图提供商 |
| GraphDTA / DeepDTA | 预测药物和靶点的结合亲和力(结合强度) | 药物的分子结构图 + 蛋白质序列 | 下游应用:利用AlphaFold的结构信息能提升预测精度。 |
| TransformerCPI | 预测药物和靶点能否结合(分类问题) | 药物的分子序列(SMILES) + 蛋白质序列 | 下游应用:同样可以受益于AlphaFold提供的结构信息。 |
| EviDTI | 同样是DTI分类预测,通过引入证据学习,在部分测试集(如DrugBank)上精度略高于TransformerCPI。 | 药物的图+蛋白质序列,外加结构/功能证据 | 下游应用:作为该领域的新方法,同样可以整合AlphaFold结构信息来提升性能。 |
核心区别:结构 vs. 功能
- AlphaFold2是“结构摄像师”:它的卓越之处在于捕捉蛋白质的3D“模样”,为药物发现提供了关键的结构蓝图。但它本身不直接回答“这个药和靶点结合得紧不紧”这样的功能问题。
- 你提到的这些工具是 “功能分析师” :它们的“本职工作”是直接预测药物与靶点的相互作用(DTI),即回答药物和靶点能否结合、结合得多紧密。这是典型的AI预测任务,属于计算生物学中的药物重定位或虚拟筛选环节,旨在快速过滤候选分子。
工作流中的协作关系
在真实的药物研发流程中,它们通常是协同工作的:
- AlphaFold提供结构:首先,对于结构未知的靶点,可以用AlphaFold预测一个可信的3D结构。
- 下游工具利用结构:然后,这些预测的或实验解析的结构,可以被整合进GraphDTA、TransformerCPI这类模型中。整合了3D结构信息的模型,其预测准确性往往优于仅使用序列信息的模型。EviDTI则进一步通过引入多源证据来强化预测。
所以,你提到的这些模型代表了DTI预测领域的一类重要方法,它们的目标与AlphaFold2不同,并且越来越多地与AlphaFold生成的结构相结合,共同推动药物发现进程。
其他行业
ChatLaw 是一个面向中文的法律大语言模型,其训练数据主要来源于法条、司法解释、法考题、判决文书、法律相关论坛和新闻等。ChatLaw 目前主要有两个版本,即 ChatLaw (13B) 和 ChatLaw (33B),分别基于 Ziya-LLaMA (13B) 和 Anima (33B)
基座模型训练获得,具有较好的法律文本理解与任务处理能力。Cuad [439] 是一个包含 510 个商业法律合同、超过 13K 个标注的合同审查数据集,由数十名法律专业人士和机器学习研究人员共同创建
Galactica [442] 是 Meta AI 公司于 2022 年 11 月推出的科学大模型,该模型通过在 48M 篇论文、教科书和讲义、数百万个化合物
和蛋白质、科学网站、百科全书等大量科学相关数据上预训练得到的
arXiv 作为全世界最大的论文预印本收集平台,其收录了近 2.4M 篇学术文章,涵盖物理学、数学、计算机科学、定量生物学等领域,
提供了非常高质量的科研文本数据。除此之外,研究人员还可以通过其他科研论文平台进行数据的收集,如 PubMed 和 Semantic Scholar,进一步扩充学术论文的范围与规模。由于科学领域数据可能包含特殊格式的数据(如蛋白质序列等),通常需要对其进行专门的处理,使其转换为统一的文本表示形式(如转成 Markdown格式)